 15 Topics
 10 Days
 75 Sessions
Programme Overview
Training Description
Who Should Attend
- Data Engineers
- ETL/ELT Developers
- Data Architects
- Analytics Engineers
- Database Developers and Administrators
- Machine Learning Engineers
- AI Engineers and Developers
- Cloud Data Engineers
- BI Developers and Data Analysts
- MLOps and DevOps Engineers
- Software Engineers working with data platforms
Session Objectives
- Understand the fundamentals of generative AI for data engineering.
- Master data synthesis and augmentation using generative models.
- Utilize AI for automated code generation and data pipeline development.
- Implement AI-driven data quality checks and anomaly detection.
- Design and build intelligent data transformation workflows.
- Optimize data pipelines with AI-powered automation.
- Troubleshoot and address common issues in AI-assisted data engineering.
- Implement AI-driven metadata management and data discovery.
- Integrate generative AI with various data engineering tools and platforms.
- Understand how to handle large-scale AI-assisted data processing.
- Explore advanced generative AI techniques for data engineering (e.g., reinforcement learning for pipeline optimization).
- Apply real world use cases for generative AI in data engineering tasks.
- Leverage generative AI tools and frameworks for efficient data engineering.
About the Course
This advanced training course explores how Generative AI is transforming modern data engineering by automating pipeline development, code generation, data transformation, documentation, testing, and workflow optimization. Participants will learn how AI-powered tools and large language models can support data engineers throughout the data lifecycle while maintaining reliability, security, governance, and quality.The course examines practical applications of Generative AI for generating SQL, Python, ETL/ELT workflows, data transformation logic, pipeline documentation, test scripts, and data quality rules. Participants will also explore AI-assisted pipeline troubleshooting, optimization, metadata generation, schema mapping, code review, and natural-language interaction with data platforms.
Through hands-on exercises and real-world scenarios, participants will learn how to integrate Generative AI into data engineering workflows, evaluate AI-generated code, improve prompts, detect errors and hallucinations, and establish human oversight. The course emphasizes responsible adoption of AI while addressing data privacy, security, governance, intellectual property, and operational risks.
Curriculum & Topics
15 Topics | 75 Sessions
-
 Workshop 1.1:
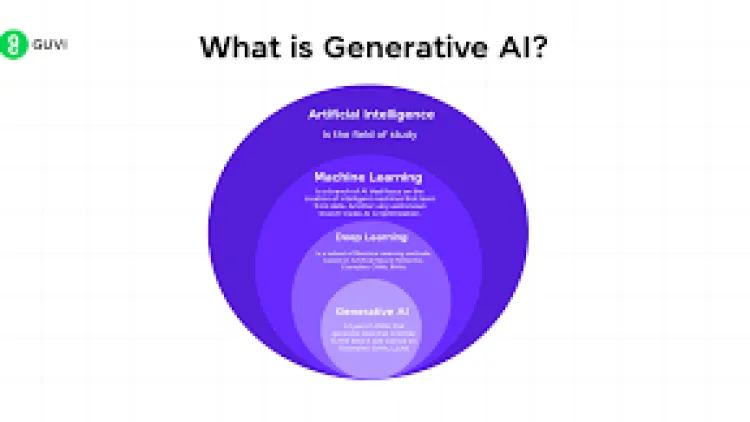
Fundamentals of generative AI for data engineering.
-
Workshop 1.2:
Overview of data synthesis, code generation, and AI-driven quality checks.
-
Workshop 1.3:
Setting up a generative AI development environment.
-
Workshop 1.4:
Introduction to generative AI tools and frameworks.
-
Workshop 1.5:
Best practices for AI-assisted data engineering.
-
Workshop 2.1:
Mastering data synthesis and augmentation using generative models.
-
Workshop 2.2:
Utilizing generative adversarial networks (GANs) and variational autoencoders (VAEs).
-
Workshop 2.3:
Implementing synthetic data generation for testing and training.
-
Workshop 2.4:
Designing and building data augmentation pipelines.
-
Workshop 2.5:
Best practices for data synthesis.
-
Workshop 3.1:
Utilizing AI for automated code generation and data pipeline development.
-
Workshop 3.2:
Implementing AI-driven SQL and Python code generation.
-
Workshop 3.3:
Designing and building automated pipeline generation tools.
-
Workshop 3.4:
Optimizing code generation for efficiency.
-
Workshop 3.5:
Best practices for code generation.
-
Workshop 4.1:
Implementing AI-driven data quality checks and anomaly detection.
-
Workshop 4.2:
Utilizing machine learning for data validation.
-
Workshop 4.3:
Designing and building anomaly detection systems.
-
Workshop 4.4:
Optimizing quality checks for data integrity.
-
Workshop 4.5:
Best practices for data quality.
-
Workshop 5.1:
Designing and building intelligent data transformation workflows.
-
Workshop 5.2:
Utilizing AI for data cleaning and preprocessing.
-
Workshop 5.3:
Implementing automated data integration and ETL processes.
-
Workshop 5.4:
Optimizing workflows for data accuracy.
-
Workshop 5.5:
Best practices for data transformation.
-
Workshop 6.1:
Optimizing data pipelines with AI-powered automation.
-
Workshop 6.2:
Utilizing reinforcement learning for pipeline optimization.
-
Workshop 6.3:
Implementing AI-driven resource management.
-
Workshop 6.4:
Designing efficient AI-assisted pipelines.
-
Workshop 6.5:
Best practices for pipeline optimization.
-
Workshop 7.1:
Troubleshooting and addressing common issues in AI-assisted data engineering.
-
Workshop 7.2:
Analyzing AI model errors and pipeline failures.
-
Workshop 7.3:
Utilizing problem-solving techniques for resolution.
-
Workshop 7.4:
Resolving common AI-driven data errors.
-
Workshop 7.5:
Best practices for troubleshooting.
-
Workshop 8.1:
Implementing AI-driven metadata management and data discovery.
-
Workshop 8.2:
Utilizing natural language processing (NLP) for metadata extraction.
-
Workshop 8.3:
Designing and building AI-driven data catalogs.
-
Workshop 8.4:
Optimizing metadata for data discovery.
-
Workshop 8.5:
Best practices for metadata management.
-
Workshop 9.1:
Integrating generative AI with various data engineering tools and platforms.
-
Workshop 9.2:
Utilizing APIs and data connectors.
-
Workshop 9.3:
Implementing AI-driven tasks within existing data pipelines.
-
Workshop 9.4:
Optimizing integration for data processing.
-
Workshop 9.5:
Best practices for integration.
-
Workshop 10.1:
Understanding how to handle large-scale AI-assisted data processing.
-
Workshop 10.2:
Utilizing distributed AI models for data processing.
-
Workshop 10.3:
Implementing data sharding and parallel processing.
-
Workshop 10.4:
Designing scalable AI-driven data architectures.
-
Workshop 10.5:
Best practices for large scale data.
-
Workshop 11.1:
Exploring advanced generative AI techniques for data engineering (reinforcement learning for pipeline optimization).
-
Workshop 11.2:
Utilizing reinforcement learning for pipeline resource allocation.
-
Workshop 11.3:
Implementing advanced AI models for data synthesis.
-
Workshop 11.4:
Designing and building advanced AI-driven solutions.
-
Workshop 11.5:
Optimizing advanced techniques for specific applications.
-
Workshop 11.6:
Best practices for advanced techniques.
-
Workshop 12.1:
Implementing generative AI for synthetic data generation in testing.
-
Workshop 12.2:
Utilizing AI for automated ETL pipeline generation.
-
Workshop 12.3:
Implementing AI-driven data quality monitoring in real-time.
-
Workshop 12.4:
Utilizing AI for metadata enrichment and data discovery.
-
Workshop 12.5:
Best practices for real-world applications.
-
Workshop 13.1:
Utilizing generative AI tools and frameworks (TensorFlow, PyTorch).
-
Workshop 13.2:
Implementing AI-driven pipelines with specific tools.
-
Workshop 13.3:
Designing and building automated workflows.
-
Workshop 13.4:
Optimizing tool usage for efficient development.
-
Workshop 13.5:
Best practices for tool implementation.
-
Workshop 14.1:
Implementing AI-driven pipeline monitoring.
-
Workshop 14.2:
Utilizing AI for anomaly detection in pipeline performance.
-
Workshop 14.3:
Designing and building performance dashboards.
-
Workshop 14.4:
Optimizing monitoring for real-time insights.
-
Workshop 14.5:
Best practices for monitoring.
-
Workshop 15.1:
Emerging trends in generative AI for data engineering.
-
Workshop 15.2:
Utilizing AI for automated data mesh implementation.
-
Workshop 15.3:
Implementing AI for data governance and compliance.
-
Workshop 15.4:
Best practices for future applications.